
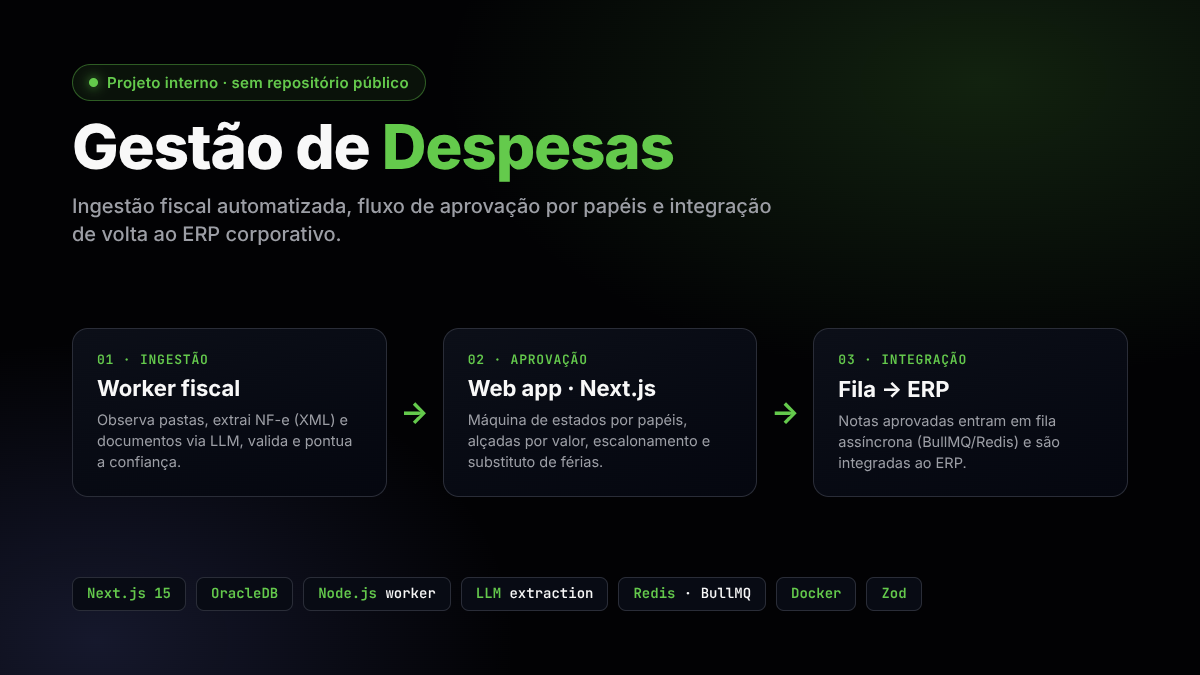

Sobre o Projeto
Gestão de Despesas — Ingestor é o worker de ingestão de documentos fiscais que alimenta o sistema de Gestão de Despesas de uma empresa do setor varejista (ver post Gestão de Despesas para a aplicação web que consome esses dados). É um serviço Node.js/TypeScript independente, com arquitetura hexagonal (domínio, aplicação, infraestrutura, interfaces), que observa pastas de rede em tempo real, extrai os dados de notas fiscais em XML, PDF e imagem — cabeçalho e itens — valida os campos e persiste tudo no OracleDB. O worker nasceu como sucessor de um pipeline de extração anterior, reescrito para rodar como serviço Node.js dedicado.
⚠️ Integração interna, sem link público. Por processar documentos fiscais reais da empresa e se conectar a pastas de rede e a um banco de dados corporativo, não há URL pública nem repositório aberto disponível. Este post descreve a arquitetura, o pipeline de extração e as principais dificuldades de forma anonimizada — sem expor endpoints internos, credenciais, nomes de hosts ou schema de banco.
O Problema
Cada área de custo (controladoria, marketing, RH, TI, manutenção, suprimentos) recebe suas próprias notas fiscais — em XML, PDF ou até imagem — depositadas em uma pasta de rede monitorada. Transformar esse fluxo bruto de arquivos heterogêneos em registros estruturados e confiáveis na base, sem digitação manual, exige resolver três problemas ao mesmo tempo:
- Formatos incompatíveis. XML é estruturado e direto de interpretar; PDF e imagem não têm estrutura nenhuma — exigem algum tipo de leitura "inteligente" do documento.
- Confiabilidade sem revisão humana de tudo. Nem toda extração automática é confiável o suficiente para entrar direto na base; mas exigir revisão manual de toda nota anularia o ganho de automatizar.
- Consistência fiscal. Campos como CNPJ, chave de acesso da NF-e e valores precisam ser validados antes de virar dado — um erro de extração que passa despercebido vira um problema financeiro rio abaixo.
O objetivo do worker é resolver a ingestão de ponta a ponta: detectar o arquivo assim que ele chega, extrair seus dados com o método certo por tipo, validar com um motor de regras fiscais, e decidir sozinho o que pode entrar direto na base e o que precisa de olhos humanos.
Arquitetura
O projeto segue arquitetura hexagonal (ports & adapters): o domínio não conhece Oracle, LLM ou sistema de arquivos — essas dependências entram por portas (domain/ports/) implementadas na camada de infraestrutura.
Camadas
domain/— o núcleo puro: a entidadeFiscalDocument(hash, status, resultado de extração), os value objects de extração (ExtractionResult,ProductItem, confiança por campo e score ponderado), oFiscalValidationEnginee as portas (ports/repositories.ts,ports/services.ts) que definem os contratos que a infraestrutura precisa implementar. Nada aqui sabe o que é Oracle, chokidar ou OpenAI.application/— o caso de uso principal (ProcessDocumentUseCase) orquestra o fluxo ponta a ponta: idempotência → extração → validação → persistência → roteamento do arquivo. OExtractionPipelinedecide entre extrator XML e LLM, aplica as penalidades de confiança e infere o tipo de documento quando ele não é óbvio pela extensão.infrastructure/— os adaptadores concretos: os extractors (XML e LLM), os repositórios Oracle (nota fiscal, itens viaexecuteManyem lote, fornecedor, loja, adiantamento) e o pool de conexões Oracle em modo thick.interfaces/— os pontos de entrada do processo: ofile-watcher(chokidar observando as pastas de entrada) e um scheduler diário que exporta, via SFTP, as notas já integradas ao ERP para um destino externo — independente do watcher principal e da ingestão em si.
Pipeline de Extração
Cada área de custo tem uma pasta de entrada monitorada, organizada por grupo. Quando um arquivo aparece, o ProcessDocumentUseCase executa:
- Detecção — o
chokidardetecta o novo arquivo na pasta de entrada. - Idempotência — calcula o SHA-256 do arquivo e checa na base se ele já foi processado; duplicatas são descartadas sem reprocessar.
- Extração — dois caminhos conforme o tipo:
- XML →
XmlExtractor, parsing estruturado direto (NF-e modelo 55 e NFS-e ABRASF). - PDF / imagem →
LlmExtractor, LLM com saída estruturada (schema Zod), cobrindo NF-e, NFS-e, notas de comunicação, boletos, faturas, notas de débito e recibos. Campos críticos do cabeçalho (CNPJs, valores) recebem double-check automático, e a concorrência de chamadas ao LLM é limitada a 2 requisições simultâneas. - Itens/produtos são extraídos no mesmo passo (código, descrição, NCM, CFOP, quantidade, valores, ICMS, IPI…); os campos fiscais mais sensíveis por item recebem instrução de prioridade máxima no prompt.
- XML →
- Validação fiscal — o
FiscalValidationEngineconfere CNPJ (mód-11), chave de acesso da NF-e, coerência de valores e datas. Cada falha aplica penalidade e reduz o score de confiança do documento. - Enriquecimento — resolve fornecedor, tipo e loja na base; detecta e corrige inversão de CNPJs (emitente × destinatário); consulta títulos em aberto do fornecedor para sinalizar adiantamentos.
- Persistência — insere cabeçalho + itens na mesma transação (rollback atômico se qualquer parte falhar), com os itens gravados em lote (
executeMany), e registra a auditoria. - Roteamento do arquivo — conforme o resultado, o arquivo é movido para
Arquivos Lidos,Revisão(score abaixo do limiar) ouFalhas, sempre organizado porano/mês.
O limiar de auto-insert sem revisão humana é 0,70. Abaixo disso, a nota vai para uma fila de revisão em vez de entrar direto no fluxo. O ciclo de vida do documento segue os estados PENDING → PROCESSING → INSERTED | REVIEW | ERROR, com APPROVED/INTEGRADA geridos depois pela aplicação web.
Normalização de Valores e Datas
Além de extrair e validar, o pipeline aplica duas regras de negócio que corrigem distorções comuns nos documentos antes de persistir:
- Valor bruto derivado. Alguns documentos só trazem o total já líquido (com desconto embutido), o que obrigava a controladoria a corrigir manualmente o campo de valor bruto em toda nota com desconto. O pipeline agora deriva
valor_nota(bruto) a partir do líquido e do desconto quando o bruto não bate com essa soma — exceto para um tipo de documento (serviço) onde o campo de valor já representa o bruto por definição, e somar o desconto de volta o infladaria incorretamente. - Inferência e ajuste de vencimento. Quando o documento não traz data de vencimento, o worker consulta o prazo de pagamento cadastrado para o fornecedor no ERP e infere a data a partir da emissão; sem prazo cadastrado, cai num prazo padrão. Em qualquer caso — inferido ou extraído —, um vencimento que cai em fim de semana é postergado para o próximo dia útil, já que é nesse dia que o pagamento é efetivamente processado.
Um Segundo Fluxo de Extração
Além do pipeline principal de notas fiscais, o worker mantém um segundo extrator LLM dedicado a um tipo de texto livre distinto — a descrição de serviços prestados por fornecedores de mão de obra terceirizada, que citam informalmente a quais solicitações internas aquele serviço se refere. Esse extrator só é acionado quando o texto sugere esse tipo de conteúdo (para não gerar custo em toda nota) e tenta casar o que foi lido contra o cadastro de solicitações — de forma acessória: qualquer falha nessa etapa é registrada e ignorada, nunca bloqueia a ingestão da nota. Um script de diagnóstico completa a caixa de ferramentas operacional do worker, para suporte quando algo foge do fluxo automático.
Principais Dificuldades
- Extração confiável de documentos heterogêneos. XML é estruturado, mas PDFs e imagens não. Usar um LLM com saída estruturada + score de confiança + limiar de revisão foi o que permitiu automatizar sem abrir mão do controle: o que o modelo não tem certeza vai para revisão humana, em vez de entrar errado na base.
- Distinção entre
nulle"0.00". Um campo não impresso na nota (null) é semanticamente diferente de um valor destacado como zero (isento/não incidente). Preservar essa diferença no schema de extração é essencial para o tratamento fiscal correto rio abaixo, na aplicação web. - Transação atômica cabeçalho + itens. Uma nota sem seus itens (ou vice-versa) é um estado inválido. Inserir os dois na mesma transação, com os itens em lote e rollback automático, garante consistência mesmo sob falha parcial.
- Domínio isolado de infraestrutura. Definir as portas (
ports/repositories.ts,ports/services.ts) antes de implementar os adaptadores obrigou a pensar no contrato do domínio primeiro — oFiscalValidationEnginee as entidades não precisam saber que existe Oracle, LLM ou sistema de arquivos por trás. - Idempotência. Um mesmo arquivo pode reaparecer na pasta. O hash SHA-256 com verificação prévia garante que reprocessar nunca gere duplicatas.
- Concorrência controlada de chamadas ao LLM. Limitar a 2 requisições simultâneas evita esgotar rate limits e picos de custo quando várias notas chegam ao mesmo tempo, sem serializar completamente o processamento.
- Exportação resiliente a falhas parciais. O job diário de exportação via SFTP pagina os registros pendentes e isola erro por registro: se um upload falhar, aquele registro é marcado e pulado, mas a paginação continua para os demais — uma falha isolada não trava o lote nem exige reprocessar tudo desde o início.
Tecnologias Utilizadas
- Node.js / TypeScript — arquitetura hexagonal (domínio, aplicação, infraestrutura, interfaces).
- LLM com saída estruturada (OpenAI) — extração de PDFs e imagens, validada por schema Zod.
- fast-xml-parser — parsing de XML estruturado (NF-e/NFS-e).
- chokidar — observação das pastas de entrada em tempo real.
- OracleDB — pool de conexões em modo thick, binds parametrizados,
executeManypara inserts em lote. - SFTP — exportação diária agendada das notas já integradas, para um destino externo à rede da empresa.
- Docker — empacotamento do worker, com Docker secrets para credenciais em produção.
Notas Técnicas
- Domínio sem dependências externas. A regra de ouro da arquitetura hexagonal se mantém: tudo que é OracleDB, LLM ou sistema de arquivos entra por uma porta definida no domínio — trocar um adaptador (por exemplo, outro provedor de LLM) não deveria exigir tocar em
domain/ouapplication/. - Separação de ingestão e operação. O worker nunca decide se uma despesa está aprovada ou não — essa responsabilidade é inteiramente da aplicação web. O worker se preocupa apenas em transformar documento bruto em registro estruturado e confiável.
- Anonimização. Endpoints internos, nomes de hosts, credenciais, schema do banco e nomes de sistemas proprietários foram deliberadamente omitidos deste post — o foco é a engenharia do pipeline de ingestão, não os dados corporativos.