

Sobre o Projeto
O LangChain RAG Lab é um estudo de caso sobre Retrieval-Augmented Generation (RAG): um laboratório interativo em que cada etapa do pipeline é explícita, pré-visualizável e configurável. Ele permite carregar documentos (.txt, .md, .pdf), inspecionar como eles são divididos em chunks, gerar embeddings via HuggingFace Inference API, persistir os vetores no PostgreSQL + pgvector e, por fim, conversar com o conteúdo através de um LLM com respostas em streaming e citação das fontes recuperadas.
Mais do que um produto acabado, o foco é entender os trade-offs de um RAG construído sobre recursos gratuitos: modelos free tier, embeddings de baixa dimensionalidade e LLMs quantizados. A interface expõe deliberadamente os parâmetros de cada etapa (split, embedding, recuperação, geração) para tornar visível como cada decisão afeta a qualidade e a assertividade das respostas.
Diferenciais
- Pré-visualização de chunks antes de qualquer gravação — nada é embutido ou persistido até a confirmação.
- Embeddings remotos via HuggingFace Inference API (modelo multilíngue de 384 dimensões) — sem modelo local, pronto para serverless.
- Busca por similaridade (distância de cosseno) sobre índice HNSW no pgvector.
- Chat RAG com streaming e exibição das fontes com o respectivo score de similaridade.
- Controle fino da geração:
temperature,top_p,top_k,max_tokens,frequency/presence penaltyesystem prompt— parâmetros desligados não são enviados à API. - Ambiente validado com zod no boot e camada de domínio OOP (services + repository) com uma
CONFIGcentral congelada.
Arquitetura
O projeto separa a interface (Next.js App Router), controllers finos (Route Handlers) e uma camada de domínio orientada a objetos que concentra toda a lógica de RAG.
Fluxo resumido: o documento é carregado (DocumentLoader), dividido (DocumentProcessor), embutido pela HuggingFace Inference API (EmbeddingsService) e persistido (VectorStoreRepository). No chat, o ChatService embute a pergunta, recupera os chunks mais similares e monta o contexto para o LLM.
EmbeddingsService e VectorStoreRepository são singletons preguiçosos (getInstance()): o cliente HuggingFace e o pool de conexão do PGVectorStore são criados uma única vez e reaproveitados entre requisições — evita reabrir conexão a cada chamada em um ambiente serverless, ao custo de um "cold start" logado explicitamente na primeira criação.
Pipeline de Ingestão
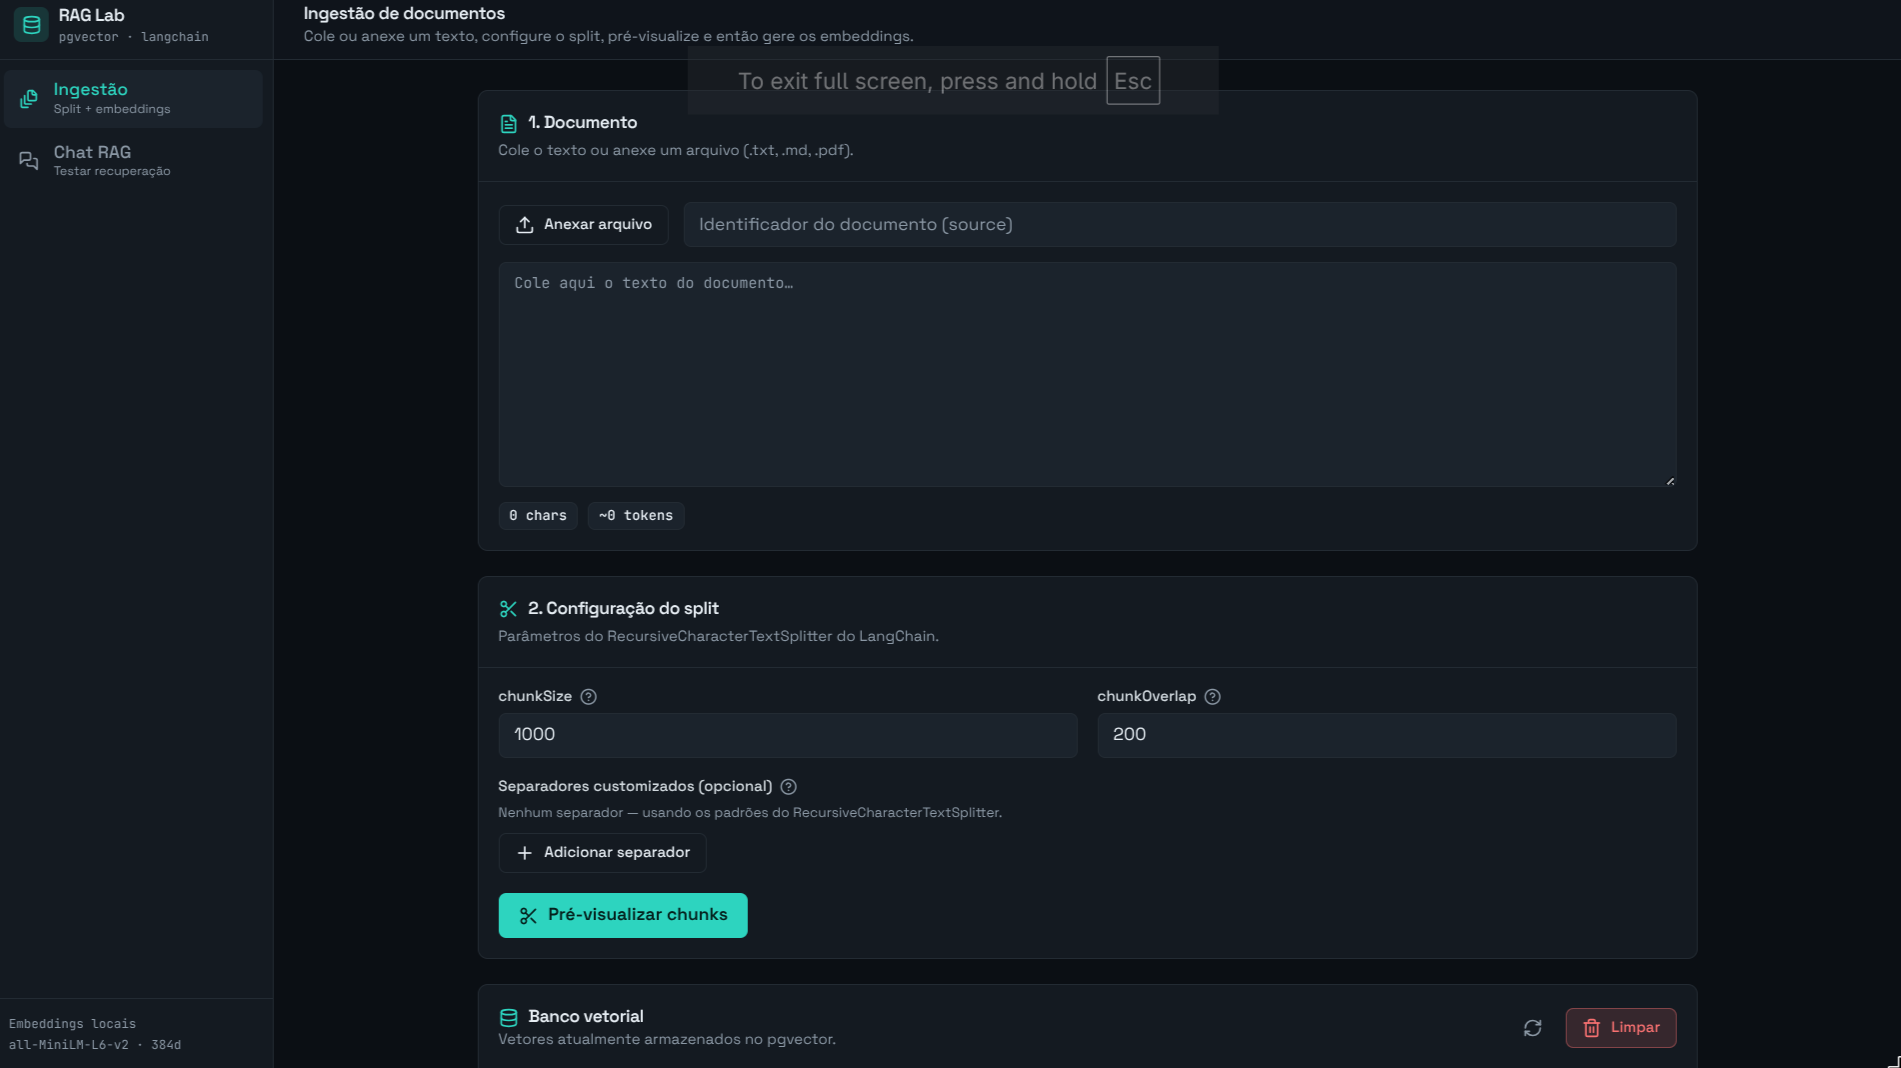
A página /ingest expõe cada etapa da preparação dos documentos:
- Documento — cole o texto ou anexe
.txt/.md/.pdf(PDF viaPDFLoaderdo LangChain, comsplitPages: false— todas as páginas são combinadas em um único texto antes do split; arquivo de tipo não suportado lança erro explícito). - Configuração do split — usando o
RecursiveCharacterTextSplitter, ajustechunkSize,chunkOverlape separadores opcionais. - Pré-visualizar chunks — mostra todos os chunks numerados e com tamanho. Nada é enviado ao modelo nem ao banco nesta etapa.
- Confirmar e gerar embeddings — cada chunk é embutido via HuggingFace Inference API e gravado no pgvector com metadados (
source,chunkIndex,totalChunks,chunkSize,chunkOverlap,splitter,ingestedAt). Alterar o texto ou a configuração invalida o preview e exige pré-visualizar novamente.
Inspetor do banco vetorial
A mesma página /ingest expõe um painel de estatísticas do pgvector, reforçando a filosofia de "nada fica opaco" além do preview de chunks:
- Total de vetores armazenados e uma badge por documento (
fonte · quantidade de chunks). - Listagem paginada (20 por página, com "carregar mais") de cada vetor individual, filtrável por documento, mostrando: os 8 primeiros valores brutos do embedding (
vector_dims+ fatiavector::real[][1:8]), o texto completo do chunk armazenado e ometadatajsonb inteiro. - Um botão de limpar tudo (
DELETE FROM embeddings, com confirmação) para zerar o banco vetorial e recomeçar um experimento do zero.
Chat com RAG
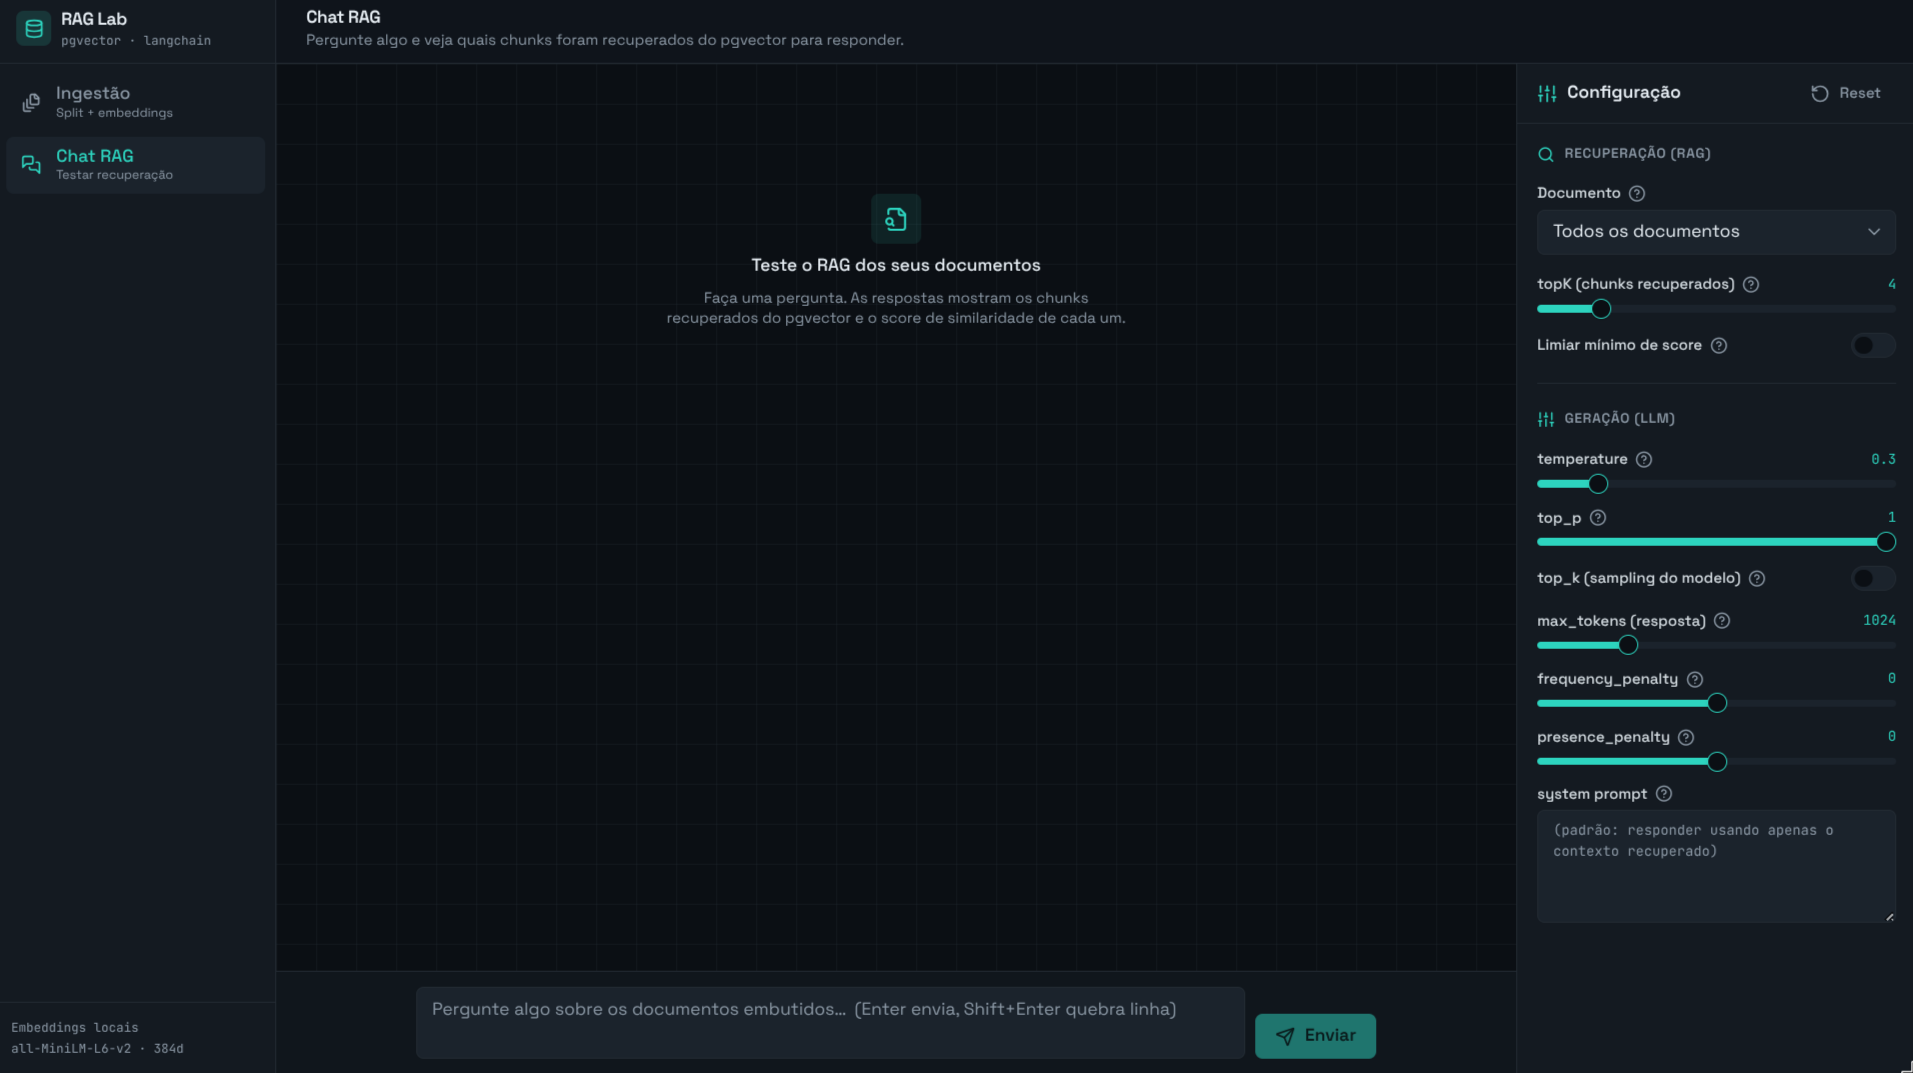
Na página /chat, o app embute a pergunta, busca os topK chunks mais similares no pgvector, monta o contexto e chama o LLM via OpenRouter com streaming.
- Cada resposta exibe as fontes recuperadas com o score de similaridade (cosseno), o modelo usado e os parâmetros aplicados.
- O painel lateral é totalmente configurável e persistido em
localStorage:- Recuperação:
topKe limiar mínimo de score — ominScoreé aplicado em código, depois da busca (filtra os resultados já retornados pelo pgvector), não como parte da query SQL. - Geração:
temperature,top_p,top_k(sampling — distinto dotopKde recuperação),max_tokens,frequency_penalty,presence_penaltyesystem prompt. Comotop_knão é um parâmetro nativo da API da OpenAI, ele é enviado viamodelKwargse repassado cru pela OpenRouter ao provedor do modelo.
- Recuperação:
- O prompt é estruturado (
promptConfig+ templates) e montado emSystemMessage(persona/regras) +HumanMessage(contexto/pergunta), com override opcional por system prompt livre.
Prompt Estruturado
Em vez de escrever um system prompt como um bloco de texto solto, o projeto trata o prompt como dado estruturado e versionável. A configuração vive em src/lib/prompt/prompt.config.json e é validada com zod (promptConfigSchema) no boot — se algo estiver malformado, a aplicação falha na inicialização em vez de mandar um prompt quebrado para o LLM.
O config separa o que o modelo deve fazer de como o texto é montado:
{
  "task": "Responder perguntas do usuário com base exclusivamente nos documentos recuperados",
  "role": "assistente especializado em consultar e extrair informações via RAG",
  "instructions": [
    "Use APENAS as informações do contexto recuperado para responder",
    "Se o contexto não for suficiente, diga claramente que não encontrou a resposta",
    "Nunca invente fatos que não estejam no contexto",
    "Quando citar um trecho, referencie o número da fonte no formato [#]",
  ],
  "constraints": {
    "language": "pt-BR",
    "tone": "objetivo e prestativo",
    "format": "texto natural com citação das fontes [#]",
  },
  "context_rules": {
    "use_only_provided_context": true,
    "indicate_if_insufficient_context": true,
  },
}
Esse config é injetado em dois templates com placeholders ({role}, {instructions}, {context}, {question}…): system.txt recebe persona e regras, e human.txt recebe o contexto recuperado e a pergunta. O buildChatPrompt renderiza os dois e devolve { system, human }, que viram SystemMessage + HumanMessage.
Por que isso importa mais do que um system prompt em texto:
- Separação de responsabilidades — persona/regras (estáveis) ficam no
SystemMessage; contexto/pergunta (voláteis) ficam noHumanMessage. Manter as instruções no papel de sistema lhes dá prioridade maior e mais resistência a prompt injection vinda do turno do usuário ou dos próprios documentos. - Validável e versionável — o prompt tem schema,
metadata(versão, autor, tags) e histórico no git. Ajustar tom, idioma ou regras é editar um campo, não reescrever um parágrafo. - Consistência — todas as respostas partem exatamente da mesma estrutura (idioma, formato de citação
[#], política de "não invente"), em vez de depender de como o prompt foi redigido daquela vez. - Override deliberado — o painel de chat ainda permite substituir tudo por um system prompt livre para experimentação, mas o caminho padrão é o estruturado.
Estudo de Caso: escolhas e trade-offs
Como o objetivo é aprender, o projeto foi montado inteiramente sobre recursos gratuitos. Isso é ótimo para custo zero e para deixar o pipeline reproduzível por qualquer pessoa, mas cobra um preço em qualidade — e enxergar esse preço com clareza é justamente o ponto do laboratório.
1. Modelos gratuitos (free tier)
O LLM de chat usa um modelo :free do OpenRouter (por padrão google/gemma-4-26b-a4b-it:free). Modelos gratuitos são, em geral, menores e/ou mais fortemente otimizados que os pagos, o que se traduz em:
- Menos capacidade de raciocínio e maior tendência a alucinar quando o contexto recuperado é fraco ou ambíguo.
- Rate limits e filas — a disponibilidade oscila e a latência sobe em horários de pico; ids
:freepodem até sair do ar (por isso o modelo é configurável por env). - Janela de contexto e throughput limitados, restringindo quantos chunks dá para injetar no prompt.
Em um RAG, a qualidade da geração depende tanto do modelo quanto da qualidade da recuperação. Com um modelo mais fraco, a recuperação precisa ser ainda mais certeira — o que nos leva ao segundo trade-off.
2. Dimensionalidade do embedding
Os embeddings usam sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2, um modelo multilíngue de apenas 384 dimensões (contra 768, 1024 ou 1536+ de modelos maiores). A dimensão do vetor é, na prática, o "orçamento" que o modelo tem para descrever o significado de um trecho:
- Menos dimensões = menor poder de representação semântica. Nuances de sentido "colidem" no mesmo espaço, e a busca por similaridade fica menos assertiva — trechos relevantes podem ficar de fora do
topK, e trechos apenas superficialmente parecidos podem entrar. - Em compensação, 384d é mais barato e rápido: vetores menores ocupam menos espaço no pgvector, o índice HNSW fica mais leve e a latência de busca cai.
- A dimensão é acoplada ao schema (
vector(384)): trocar o modelo de embedding por um de outra dimensão exige recriar a coluna e re-ingerir todos os documentos.
Escolher 384d multilíngue foi um trade-off consciente: bom o suficiente para português, barato e serverless-friendly, ao custo de precisão de recuperação.
3. Quantização
Reduzir o tamanho do modelo trocando a forma como os pesos são representados. Ex.: passar de 16 bits para 8 bits — ou até 4 bits — diminui o tamanho do modelo e acelera a inferência, mas pode impactar a qualidade das respostas.
A ideia é reduzir a precisão numérica usada para armazenar (e às vezes calcular) os pesos, de modo que o modelo ocupe menos memória e rode mais rápido — ao custo de alguma perda de qualidade.
Os sufixos no nome do modelo indicam quantos bits são usados. Tomando como exemplo Llama-3-8B-Instruct-q4f32_1-MLC:
q4→ os pesos (weights) do modelo foram armazenados em 4 bits.f32→ as ativações (tensores/cálculos intermediários durante a inferência) ficam em float32 (32 bits), enquanto o original costuma ser float16._1→ identificador interno da variante/receita de quantização usada pelo MLC (diferenças de algoritmo, calibração, esquema de empacotamento, etc.).
O modelo fica menor principalmente por causa dos pesos em 4 bits, enquanto manter as ativações em float32 ajuda a preservar estabilidade numérica e qualidade de inferência. Em resumo, a quantização é o botão que troca precisão por memória e velocidade — e entendê-la é essencial para escolher, comparar ou rodar modelos localmente (por exemplo, builds MLC/WebLLM no navegador).
Resumindo os trade-offs
| Escolha | Ganho | Custo |
|---|---|---|
LLM :free (OpenRouter) | Custo zero, sem infra | Menos capacidade, rate limits, mais alucinação |
| Embedding 384d multilíngue | Rápido, barato, serverless | Recuperação menos assertiva |
| Quantização (ex.: q4) | Menos memória, mais velocidade | Perda de precisão numérica |
Como mitigar (caminhos naturais de evolução do estudo): subir para embeddings de maior dimensão, aumentar topK com um limiar de score mais rígido, melhorar o chunking (tamanho/overlap por tipo de documento), adicionar re-ranking e, quando o orçamento permitir, trocar o LLM :free por um modelo pago ou por um local menos quantizado.
Tecnologias Utilizadas
Framework
- Next.js 15 — Framework React com App Router
- React 19 — Biblioteca de interface
- TypeScript — Tipagem estática em todo o projeto
Orquestração RAG
- LangChain (
@langchain/core,@langchain/community,@langchain/textsplitters,@langchain/openai) — splitters, loaders e integração com o vector store - HuggingFace Inference API — embeddings com o modelo
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2(384 dimensões) - OpenRouter — LLM de chat (modelo
:freeconfigurável) com respostas em streaming
Banco de Dados
- PostgreSQL 16 — Persistência principal
- pgvector — Armazenamento de vetores com índice HNSW e distância de cosseno
- Supabase — Base vetorial em produção (Transaction pooler)
Frontend
- Tailwind CSS — Estilização utility-first
- shadcn/ui — Componentes baseados em Radix UI
- React Hook Form — Gerenciamento de formulários
- React Markdown (
react-markdown+remark-gfm) — Renderização das respostas - Zod — Validação de schemas (rotas + variáveis de ambiente)
Infraestrutura
- Docker — PostgreSQL + pgvector local em desenvolvimento
- Vercel + Supabase — Deploy da aplicação e da base vetorial em produção
Notas Técnicas
- Similaridade exibida =
1 - distância_cossenodo pgvector (0..1, maior = mais similar). serverExternalPackagesnonext.config.mjsevita empacotarpdf-parseepgno bundle do servidor;outputFileTracingIncludesgarante que os arquivos de prompt (lidos viafs) sigam junto na função da Vercel.- A dimensão do vetor (
384) é acoplada ao modelo de embeddings; trocar o modelo requer re-ingerir os documentos. - Toda variável de ambiente é validada com zod no boot (
src/lib/env.ts) — se algo estiver faltando ou inválido, a aplicação falha na inicialização com uma mensagem clara. - Índices do pgvector. A tabela
embeddingsmantém um índicehnsw (vector vector_cosine_ops)para a busca por similaridade e um índice separado sobremetadata->>'source', usado quando o chat ou o inspetor filtram por um documento específico. - Protocolo do streaming. O corpo da resposta de
/api/chaté<JSON de metadados><delimitador>__ANSWER__<tokens da resposta...>; se a geração falhar no meio do stream, um segundo delimitador (__ERROR__) é anexado com a mensagem de erro — o cliente sempre consegue distinguir metadados, texto de resposta e falha tardia no mesmo corpo de resposta.